遵规和逾矩:
从书法中的数学讲起
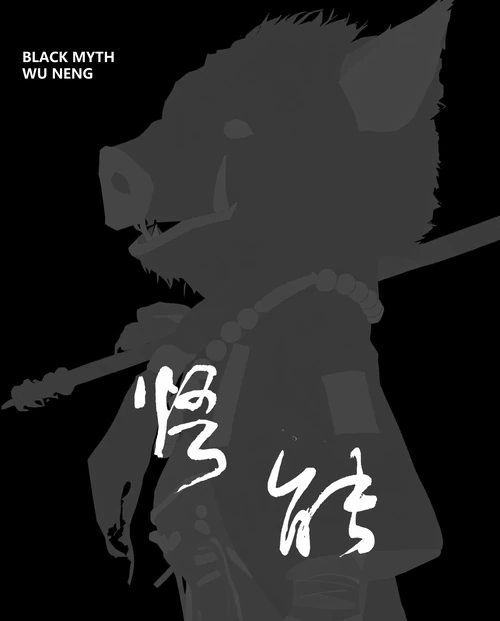
现在的生图模型都写不好汉字,这已经是共识了。想出图的做法也基本一致:生成、擦去,然后纠正。
“纠正”这一步,对于印刷品那种规则的文字来说并不神秘,选一个文字排版引擎就够了。绘图库可以把字符串栅格化到图上的指定位置,浏览器本身就是一套极其成熟的排版引擎,TeX 更是把排版本身当作一门科学,断行、对齐、间距都是全局优化出来的结果。总之,只要文字是规则的,“重新排上去”就是一个早就被解决得很好的工程问题。
但这些引擎有一个共同的前提:它们都依赖字体文件。打开任何一个 .ttf / .otf,里面除了字形轮廓,还躺着一整套度量元信息:基线、小写字身高度、大写字高、上伸部与下延部……排版引擎正是拿着这些数值做计算的:这个字落在哪条线上,两个字之间隔多少,一行从哪里断开。换句话说,规则文字的排版本质上是一个求解方程的过程:字体度量给出系数,排版引擎负责求解,答案就是每个字的精确坐标。
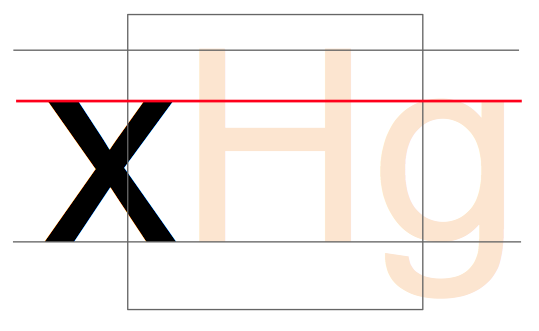
但是,对于一个书法字体,我们该怎么排版呢?
麻烦在于,书法里根本没有这些元信息。一幅行草里找不到一条统一的基线让每个字落脚:字有大有小、有欹有正,“之”可以缩成一团,“一”可以拉成一笔长横;也没有统一的字身高度,笔画随时可以冲破想象中的字框,一根悬针竖就能拖出半个字长。字体文件里那套从度量到求解的流水线,在这里从源头就不成立。
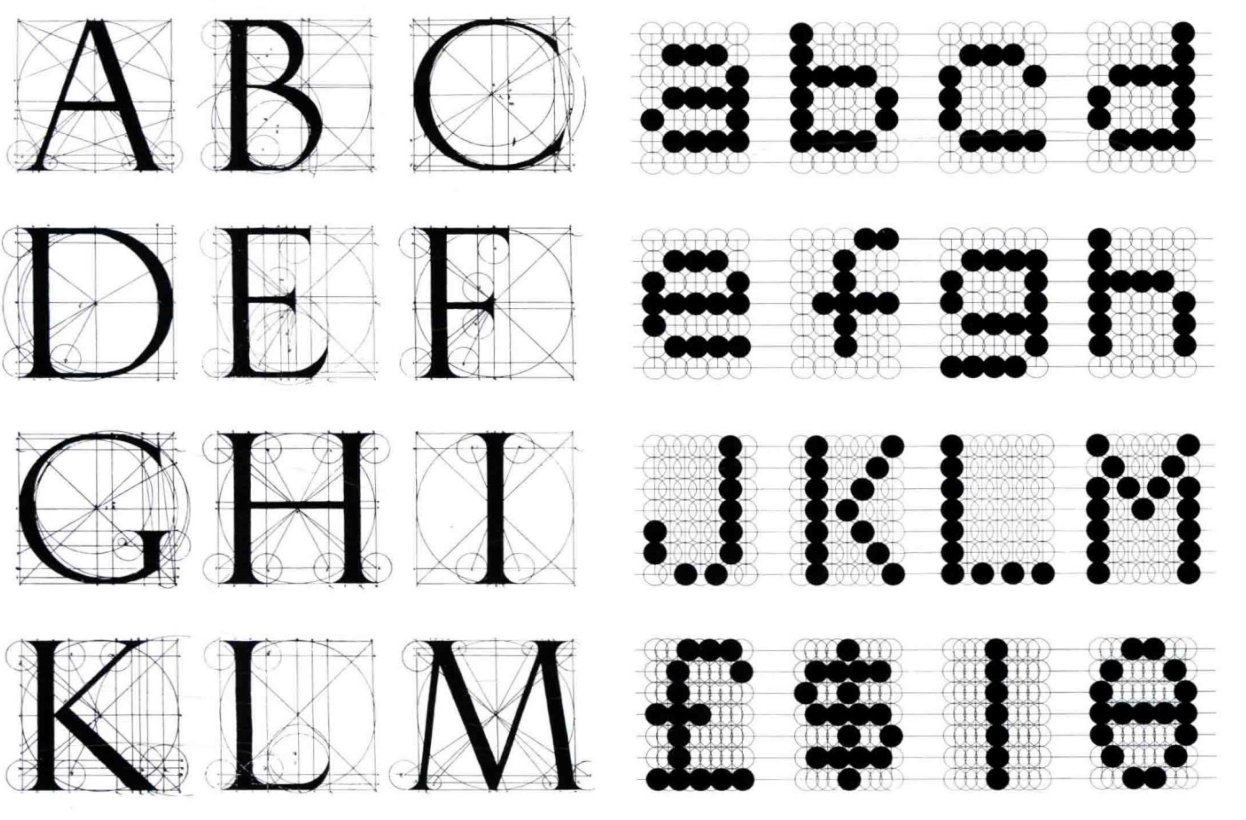
然而,字体的辅助线其实也并非几条水平线那么简单。往精细里做,有动用丰富数学符号的:字母的每一笔都被还原成圆规与直尺的几何构造,圆弧的圆心、切线的角度都标注得清清楚楚;往另一个极端走,也有类似“拼豆”效果的:干脆放弃连续笔画,用一颗颗墨点的排列去逼近字形。
那书法有没有这样的结构呢?“永字八法”给了我启发:
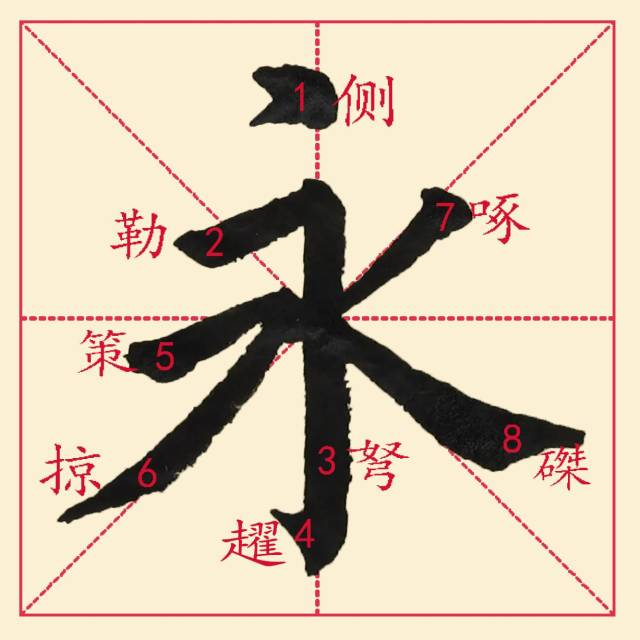
虽然王羲之写《兰亭》的时候是随心所欲的,但后人临习确实还原出了“米字格”、“回宫格”这样的参考系统。要是 AI 也能做到这一点就好了,从结果反推标准,而这其实正是它所擅长的。
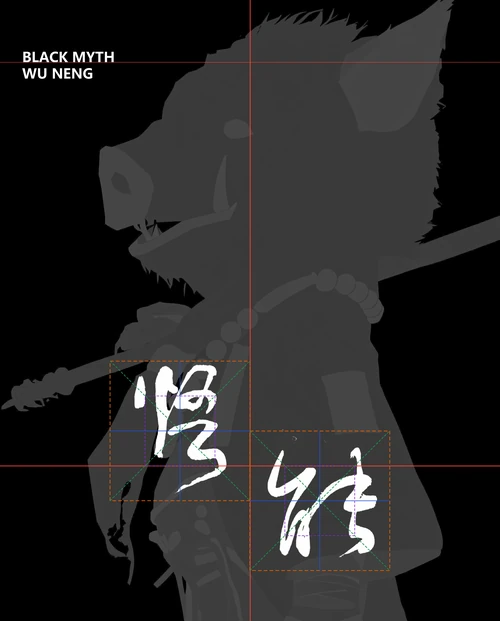
于是,我们用基础的视觉模型,试图去做到这一点,效果还不错:
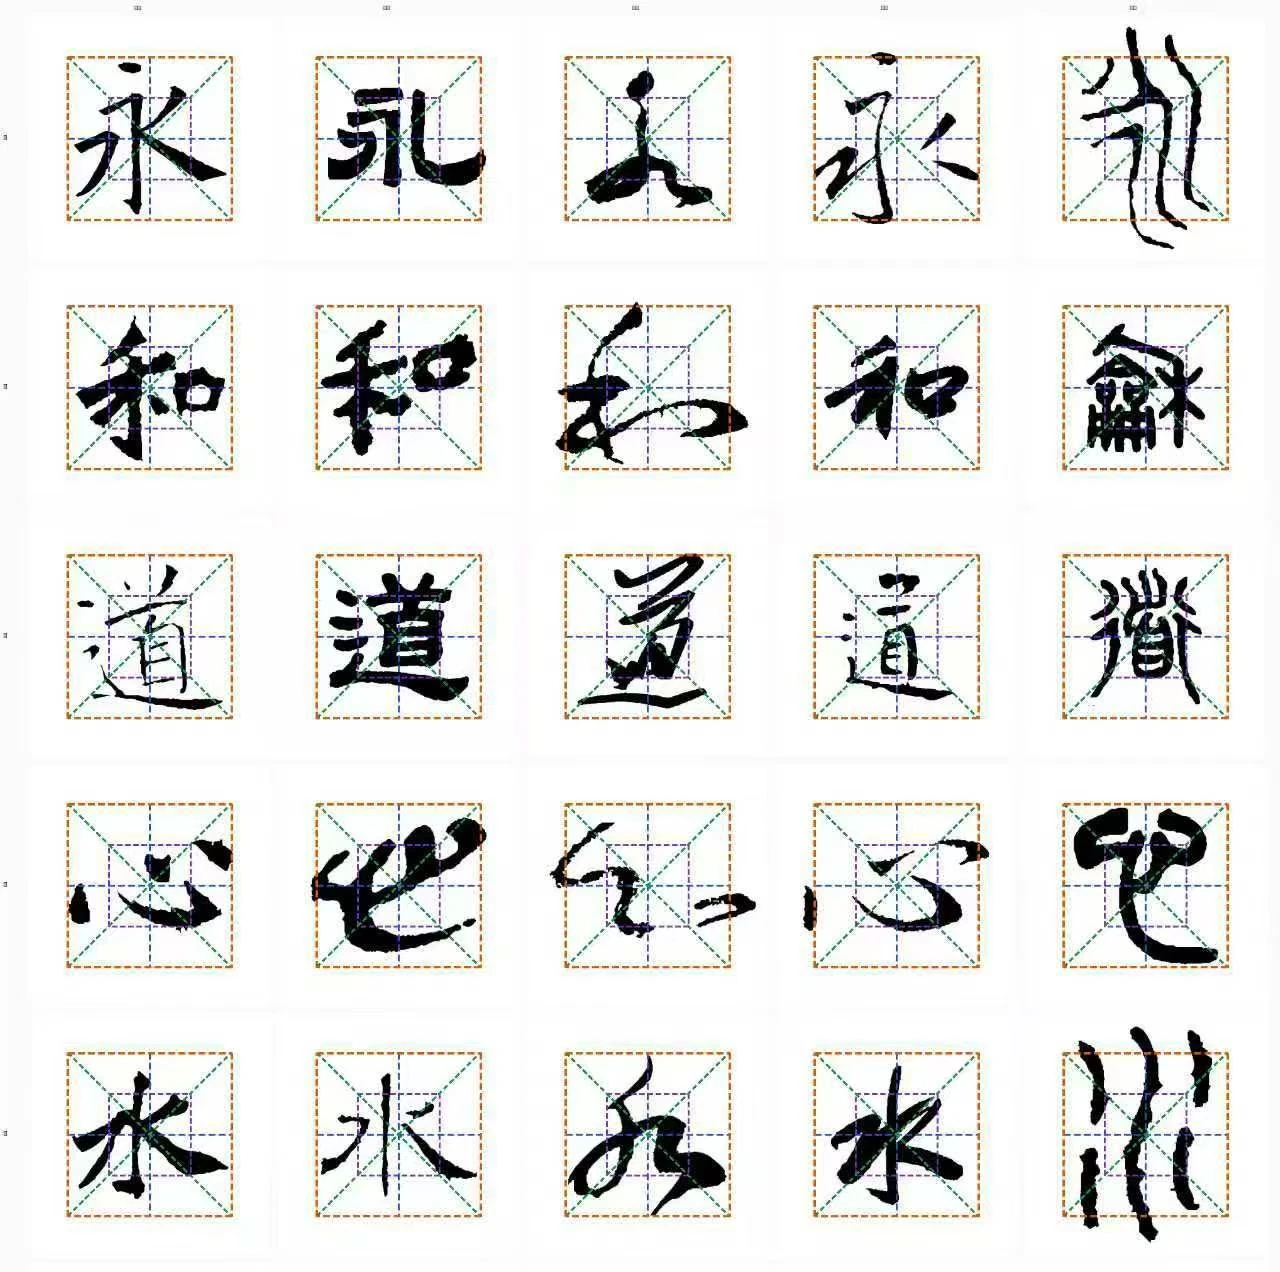
有了中宫作为参考线,排版也就变得有据可循了。我们可以选择回宫格内部的下边缘线作为基线,也可以错位排版,做出更有创意的排版。
(未完待续)